Теория
Вычисляем F(5) по правилу
Последовательность чисел не обязательно перечислять целиком. Можно задать первое значение и правило, по которому из уже известного получается следующее. Такую запись называют рекуррентным определением. Здесь F(n) — значение с номером n.
Пусть первое значение равно F(1) = 1, а каждое следующее получается по правилу F(n) = 2·F(n − 1) + 1 при n > 1. Формула сама по себе ничего не считает — чтобы найти F(n), сначала нужно знать F(n − 1). Найдём F(5), поднимаясь от того, что уже известно.
- F(1) = 1 — это значение дано, вычислять его не нужно.
- F(2) = 2·F(1) + 1 = 2·1 + 1 = 3.
- F(3) = 2·F(2) + 1 = 2·3 + 1 = 7.
- F(4) = 2·F(3) + 1 = 2·7 + 1 = 15.
- F(5) = 2·F(4) + 1 = 2·15 + 1 = 31.
Зачем нужны база и шаг
В первом примере мы использовали две части определения. Первая — начальное значение, от которого можно начать вычисления. Его называют базовым случаем: F(1) = 1 просто дано, вычислять его не нужно. Вторая часть — правило перехода: F(n) = 2·F(n − 1) + 1 при n > 1, которое показывает, как получить следующее значение из предыдущего.
Посмотрим, как обе части работают вместе. Чтобы найти F(5), правило требует F(4), для него нужно F(3), и так далее: вопросы идут вниз. Они останавливаются на F(1) — это значение дано. С него ответы поднимаются вверх: из каждого найденного значения получается следующее.
Теперь уберём базу. Если в определении нет значения F(1), то вопрос «чему равно F(1)?» тоже требует предыдущего значения F(0), затем F(-1) и так без конца. Это как ряд костяшек домино: без первого толчка (без базового случая) ни одна костяшка не упадёт.
С базой определение не ходит по кругу: вопросы упираются в известное значение, а дальше каждое значение опирается только на уже найденное — из F(1) однозначно получается F(2), из него — F(3), и так для любого n. Это тот же принцип, что у математической индукции: база плюс шаг, работающий для каждого n. Важно, чтобы аргумент на каждом шаге приближался к базе — тогда цепочка обязательно закончится.
Рекурсивная функция и стек вызовов
Пока мы поднимались от базового значения вручную. Ту же цепочку можно поручить Python. Функцию, которая во время вычисления вызывает саму себя, называют рекурсивной. Как устроены аргументы и return, разобрано в уроке курса «Функции», а как вызовы уходят вглубь и возвращаются — в уроке «Рекурсия».
def F(n): if n == 1: return 1 # Базовый случай: значение уже известно return 2 * F(n - 1) + 1 # Шаг: сначала находим F(n - 1) print(F(5))Чтобы увидеть, что происходит при вызове F(4), добавим печать до и после рекурсивного вызова:
def F(n): print("вызов", n) if n == 1: print("база", n) return 1 result = 2 * F(n - 1) + 1 print("возврат", n, "->", result) return result F(4) # Программа напечатает:# вызов 4# вызов 3# вызов 2# вызов 1# база 1# возврат 2 -> 3# возврат 3 -> 7# возврат 4 -> 15Сначала вызовы уходят вглубь — 4, 3, 2, 1 — пока не будет достигнут базовый случай. Пока это не произошло, каждый вызов приостановлен и ждёт результата вложенного вызова: Python хранит такие ожидающие вызовы в стеке вызовов. После базы значения возвращаются в обратном порядке — 2, 3, 4 — и каждый вызов завершается, получив нужное число. В строке result = 2 * F(n - 1) + 1 выражение F(n - 1) — уже не запись, а конкретное число, которое вернул вложенный вызов.
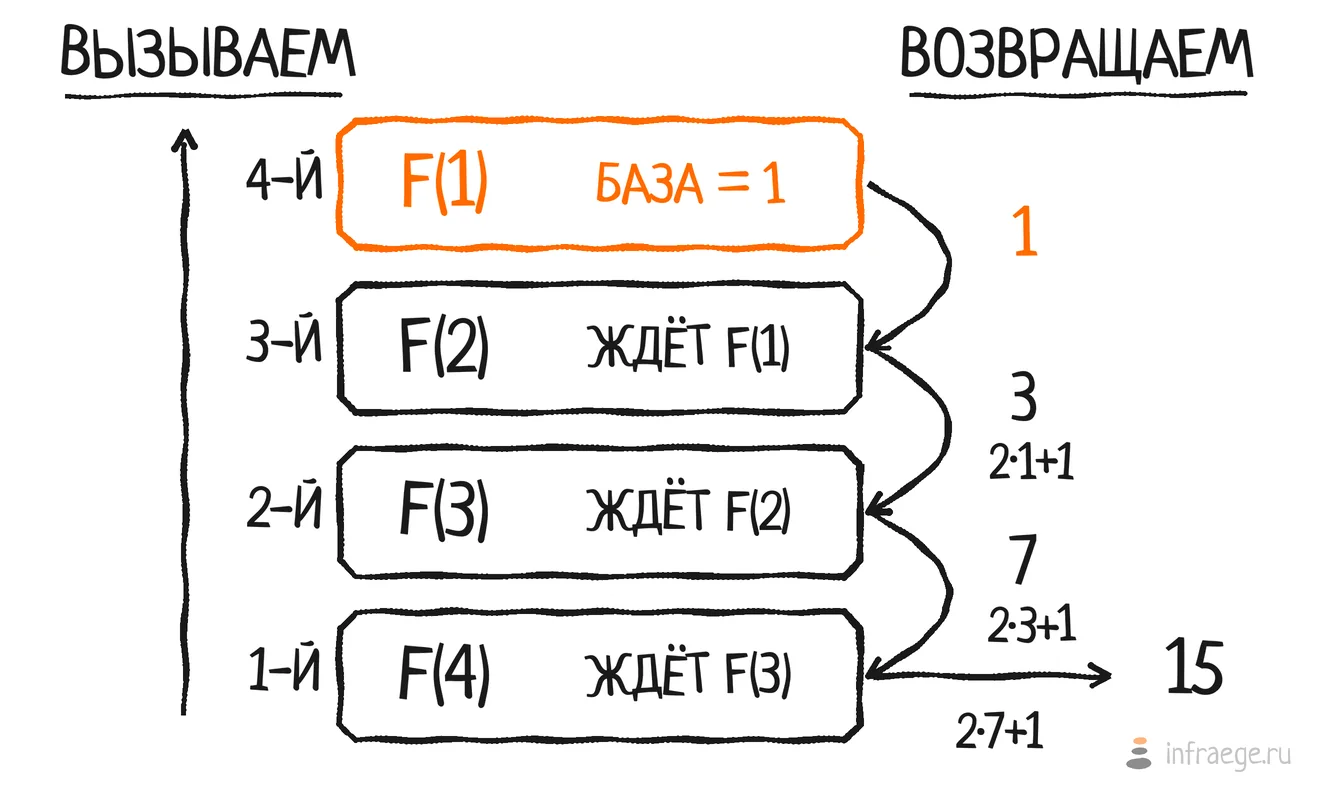
У стека есть предел: по умолчанию Python допускает около 1000 вложенных вызовов. Для функции F(n) = n·F(n − 1) вызов F(2024) — это цепочка из двух тысяч ожидающих вызовов, и она не помещается:
def F(n): if n == 1: return 1 return n * F(n - 1) print(F(2024)) # RecursionError: превышена глубина рекурсииОдин из способов — поднять лимит на длину цепочки с небольшим запасом:
import sys # Глубина цепочки 2024, лимит чуть большеsys.setrecursionlimit(5000) def F(n): if n == 1: return 1 return n * F(n - 1) print(F(2024) // F(2022)) # 4094552Это только один инструмент из нескольких. Следующие разделы показывают другие способы — цикл, кеш, прогрев кеша — и объясняют, когда какой выбирать.
Цикл: одно значение вместо стека
Когда каждое значение зависит только от предыдущего, стек не нужен вовсе: в каждый момент достаточно помнить последнее найденное значение. Цикл перезаписывает одну переменную и не откладывает вызовы:
f = 1 # Начинаем с известного F(1) for n in range(2, 2025): f = n * f # Новое значение заменяет предыдущее print(f) # Общий шаблон для одного предыдущего значения:# f = базовое_значение# for n in range(первое_n, target + 1):# f = ... # формула через предыдущее значение f# print(f)Цикл — не «более правильный» способ, а другой инструмент. Он хорошо подходит для линейной цепочки, где шаг всегда «предыдущее значение → следующее». Если аргумент перепрыгивает (n / 2, n + 4) или значение зависит от условия, цепочку проще записать рекурсией — так мы и будем делать дальше.
f после каждого шага цикла — так проверяют цикл на малых значениях.- Перед циклом
f = 2— это F(1). n = 2: f = 3·2 − 1 = 5.n = 3: f = 3·5 − 1 = 14.n = 4: f = 3·14 − 1 = 41.n = 5: f = 3·41 − 1 = 122 — это и есть F(5).
f = 2 for n in range(2, 6): # 6: граница range не включается f = 3 * f - 1 print(f) # 122Когда нужны два предыдущих значения
До сих пор для нового значения хватало одного предыдущего. Но иногда формула зависит сразу от двух: F(n) = F(n − 1) + F(n − 2). Тогда одного базового значения недостаточно — уже для F(3) нужны сразу F(2) и F(1), поэтому определение обязано задать оба сразу: F(1) = 2, F(2) = 3.
Самый известный пример — числа Фибоначчи: F(1) = F(2) = 1 и F(n) = F(n − 1) + F(n − 2), то есть 1, 1, 2, 3, 5, 8, … Если формула берёт три предыдущих значения, нужно три базовых. Например, при 1, 1, 2 и сумме трёх предыдущих получается 1, 1, 2, 4, 7, 13, 24 — это числа трибоначчи. В задачах базовые значения могут быть другими: их всегда берут из условия, а не из памяти о «стандартной» последовательности.
- F(3) = F(2) + F(1) = 3 + 2 = 5.
- F(4) = F(3) + F(2) = 5 + 3 = 8.
- F(5) = F(4) + F(3) = 8 + 5 = 13.
- F(6) = F(5) + F(4) = 13 + 8 = 21.
Повторные вызовы и кеш
Для зависимости от одного значения главной опасностью была глубина стека. У рекурсивной функции с двумя предыдущими значениями появляется другая проблема. Возьмём числа Фибоначчи, запишем их рекурсивно и выпишем, какие вызовы порождает F(5):
def F(n): if n <= 2: return 1 return F(n - 1) + F(n - 2) # Вызовы, которые порождает F(5):# F(5)# ├─ F(4)# │ ├─ F(3)# │ │ ├─ F(2)# │ │ └─ F(1)# │ └─ F(2)# └─ F(3)# ├─ F(2)# └─ F(1)В дереве вызовов F(3) вычисляется дважды, а F(2) — трижды: одно и то же значение считается заново, хотя уже было найдено.
Измерим, насколько это плохо. Будем считать, сколько раз вычисляется F(3):
count = 0 def F(n): global count if n == 3: count += 1 # Считаем повторы F(3) if n <= 2: return 1 return F(n - 1) + F(n - 2) for n in (10, 15, 20, 25): count = 0 F(n) print(n, count) # Программа напечатает:# 10 21# 15 233# 20 2584# 25 28657Число повторов растёт так же быстро, как сами числа Фибоначчи. Для F(40) такая программа делает больше двухсот миллионов вызовов — работа занимает минуты, хотя ответ можно получить за сорок шагов. Идея исправления очевидна: один раз вычислить значение и запомнить его. Это называют кешированием, а в Python его берёт на себя декоратор lru_cache из модуля functools — отметка перед функцией:
from functools import lru_cache @lru_cache(None)def F(n): if n <= 2: return 1 return F(n - 1) + F(n - 2) print(F(40)) # 102334155 — мгновенноТеперь каждое значение вычисляется один раз, а при повторном обращении берётся из памяти. Сравните деревья вызовов без кеша и с кешем:
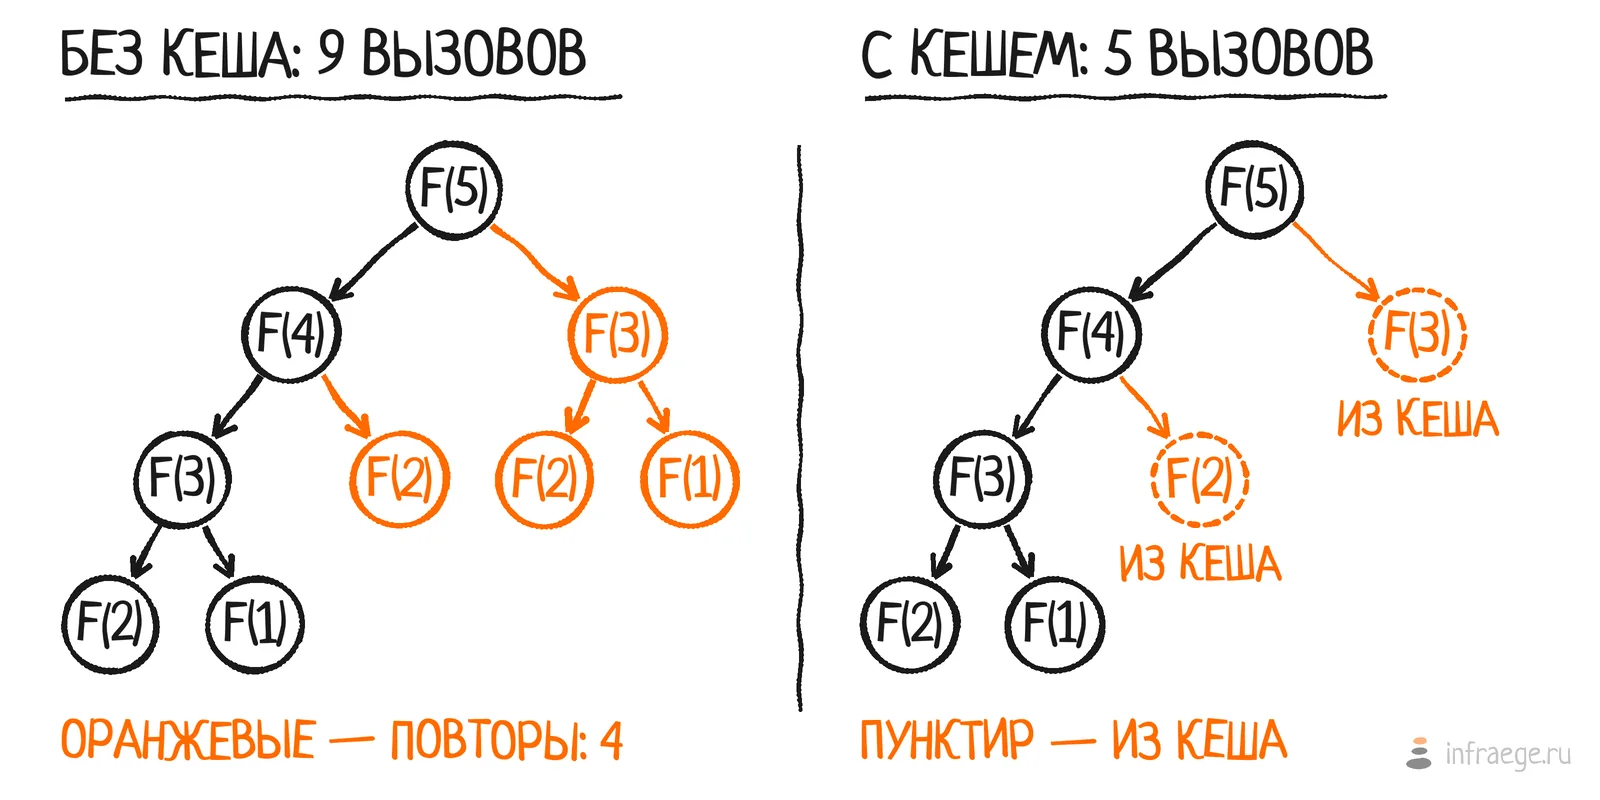
Аргумент None — «не ограничивать размер кеша». Если написать @lru_cache() без аргумента, Python по умолчанию запомнит лишь 128 последних значений, а более старые забудет, и часть работы снова будет повторяться. (Начиная с Python 3.9 есть краткая запись @cache — то же самое, что lru_cache(None); запись с None работает везде.)
Есть и способы обойтись без кеша. Можно хранить значения в списке, где индекс — это аргумент, а для следующего значения нужны только два последних, поэтому хватит и двух переменных:
# Способ 1: список, индекс — это аргументtarget = 6F = [0] * (target + 1) # Два базовых значения нужны до первого шагаF[1] = 2F[2] = 3 for n in range(3, target + 1): F[n] = F[n - 1] + F[n - 2] # Сохраняем один раз print(F[target]) # Способ 2: две переменные вместо спискаf_prev2, f_prev1 = 2, 3 for n in range(3, 7): # Правая часть берёт оба старых значения f_prev2, f_prev1 = f_prev1, f_prev1 + f_prev2 print(f_prev1)f_prev2 = f_prev1, а потом f_prev1 = f_prev1 + f_prev2 — порядок не важен.f_prev2 уже стало равно старому f_prev1, поэтому вторая строка складывает f_prev1 само с собой, а не с настоящим предыдущим значением. Сначала нужно вычислить новое значение в отдельную переменную и только потом обновить обе хранимых: f_current = f_prev1 + f_prev2; f_prev2 = f_prev1; f_prev1 = f_current.Шаг не на 1: деление аргумента
До сих пор аргумент уменьшался на 1 или на 2. В заданиях часто встречается другой шаг: аргумент делится, например на 10 или на 2. Тогда даже огромное число, вроде 10³⁰, доходит до базового случая за несколько десятков вызовов. Для такой записи нужны две операции. Оператор // — деление нацело, оператор % — остаток. Для 472: 472 // 10 равно 47 (число без последней цифры), а 472 % 10 равно 2 (последняя цифра).
Пусть F(n) = n при n < 10, а при n ≥ 10 значение равно n%10 + 2·F(n//10): последняя цифра плюс удвоенное значение для числа без неё.
from functools import lru_cache @lru_cache(None)def F(n): if n < 10: return n return n % 10 + 2 * F(n // 10) print(F(472)) # 32print(F(10 ** 30)) # 1073741824Цепочка для 10³⁰ — это всего 31 вызов, поэтому ни цикл «от 1 до n», ни увеличение лимита здесь не нужны: аргумент уменьшается в десять раз на каждом шаге.
- 472 ≥ 10, поэтому F(472) = 472%10 + 2·F(47) = 2 + 2·F(47).
- 47 ≥ 10: F(47) = 7 + 2·F(4).
- 4 < 10 — базовый случай: F(4) = 4.
- Поднимаемся: F(47) = 7 + 2·4 = 15, затем F(472) = 2 + 2·15 = 32.
n // 10 можно писать n / 10 — в Python это одно и то же, разница только в записи./ всегда возвращает дробное число: 472 / 10 даёт 47.2, а даже 9 / 3 — 3.0. Для огромных чисел хуже: 10 ** 30 / 10 — это уже приближённое 1e+29, и часть цифр потеряна. Если в задании аргумент должен остаться целым, берут //.Разные правила для чётных и нечётных
В заданиях формула часто зависит от условия на аргумент: свои правила для чётных и нечётных n, для разных диапазонов. Тогда функция состоит из нескольких веток, и для каждого n нужно сначала выбрать подходящую. Условие «чётное» записывают как n % 2 == 0: остаток от деления на 2 равен нулю.
Рассмотрим функцию: F(1) = 1; F(n) = F(n/2) + 3, если n > 1 и n чётно; F(n) = F(n − 1) + 1, если n > 1 и n нечётно. Здесь при чётном n значение n/2 — целое, поэтому в программе пишут n // 2. Вручную такую цепочку удобнее разворачивать сверху вниз: записывать, какая ветка применяется на каждом шаге, а затем подниматься.
- 21 нечётно: F(21) = F(20) + 1.
- 20 чётно: F(20) = F(10) + 3; затем 10 чётно: F(10) = F(5) + 3.
- 5 нечётно: F(5) = F(4) + 1; затем 4 чётно: F(4) = F(2) + 3, а F(2) = F(1) + 3.
- F(1) = 1 — базовый случай. Поднимаемся: F(2) = 4, F(4) = 7, F(5) = 8, F(10) = 11, F(20) = 14.
- F(21) = F(20) + 1 = 15.
from functools import lru_cache @lru_cache(None)def F(n): if n == 1: return 1 # База проверяется первой if n % 2 == 0: return F(n // 2) + 3 return F(n - 1) + 1 print(F(21)) # 15 — совпало с ручным счётомif неважен: можно сначала разобрать чётность, а базовый случай n == 1 проверить в конце.Рекурсия «вверх» и прогрев кеша
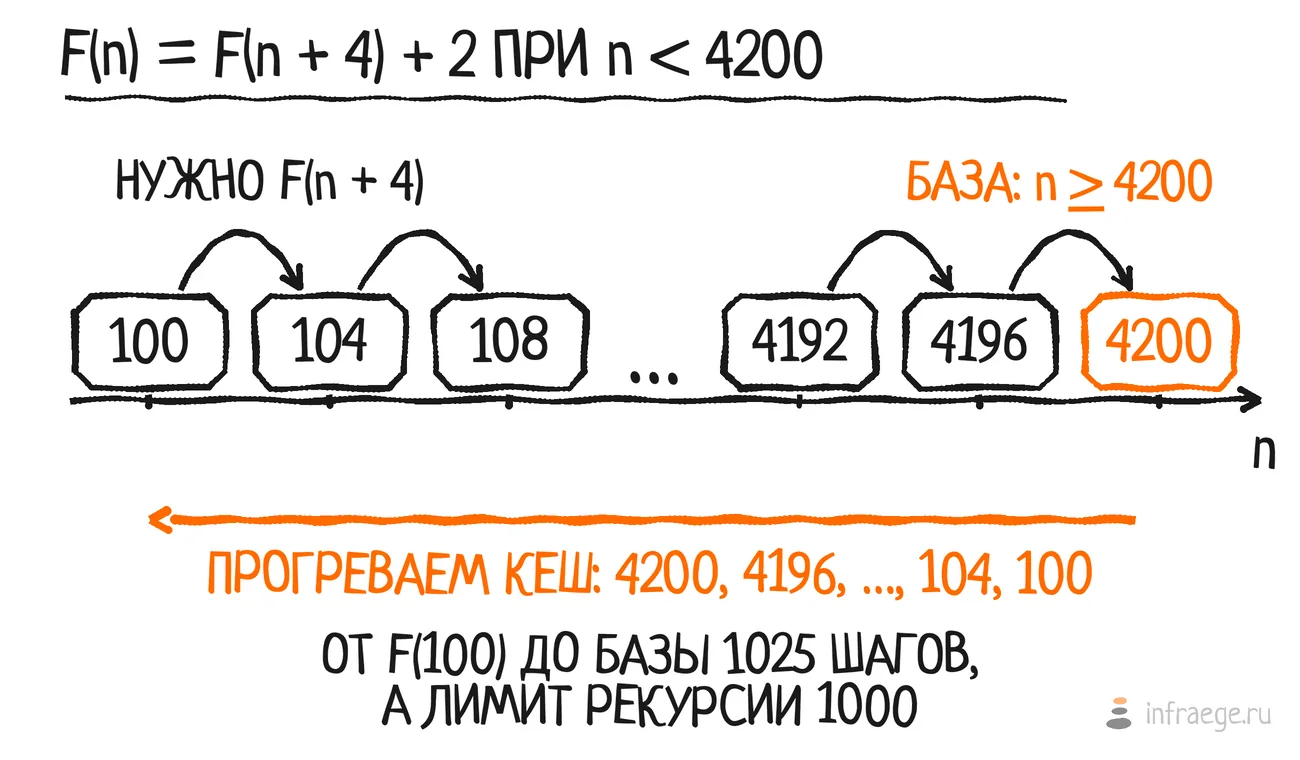
Иногда значение выражается не через меньшие аргументы, а через большие: F(n) = F(n + 4) + 2 при n < 4200, а база задана сверху — F(n) = 7 при n ≥ 4200. Аргумент растёт до тех пор, пока не достигнет базы, поэтому цепочка идёт «вверх». Значит, считать «снизу вверх от F(1)» здесь нельзя: считать нужно от базы вниз к запрошенному аргументу.
Цепочка от F(100) до базы — больше тысячи вызовов, и обычная рекурсия упрётся в лимит. Кеш здесь не спасает: пока не дошли до базы, ничего не посчитано и запоминать нечего. Выход — «прогреть кеш»: заранее вызвать функцию для подходящих аргументов в таком порядке, чтобы каждый вызов опирался на уже запомненное значение. Порядок выбирают против направления зависимости: раз F(n) нуждается в F(n + 4), идём от больших n к малым. Верхняя граница прогрева — первое значение, попадающее в базу. Если бы функция зависела от F(n − 1), порядок был бы обратным: от малых к большим.
- Формула связывает F(96) = F(100) + 2, поэтому F(100) − F(96) = −2 без вычисления самих значений.
- Чтобы найти F(100), нужно подняться от 100 до 4200 с шагом 4: это (4200 − 100) / 4 = 1025 шагов, каждый добавляет 2, а в базе 7.
- F(100) = 7 + 2·1025 = 2057, а F(96) = 2059.
- Проверяем программой. Цепочка из 1025 вызовов длиннее стандартного лимита, поэтому сначала заполняем кеш от больших n к малым — так каждый вызов сразу берёт результат из кеша.
from functools import lru_cache @lru_cache(None)def F(n): if n >= 4200: return 7 return F(n + 4) + 2 # F(n) требует F(n + 4): идём от больших n к малымfor n in range(4200, 95, -1): F(n) print(F(100), F(100) - F(96)) # 2057 -2Две связанные функции F и G
В некоторых заданиях определены сразу две функции, и каждая может вызывать другую: например, F(n) = F(n − 1) + G(n − 2) и G(n) = G(n − 1) + F(n − 1). Идея решения не меняется: ищем базовые значения обеих функций, понимаем, от каких значений зависит каждая, и поднимаемся. Удобно вести таблицу с двумя столбцами — строка для каждого n. В программе обе функции получают свой @lru_cache(None).
F(n) = 1, G(n) = 2 при n ≤ 2,
а при n > 2: F(n) = F(n − 1) + G(n − 2),
G(n) = G(n − 1) + F(n − 1)
- n = 1, 2: базовые значения даны, F = 1 и G = 2. Это первые две строки таблицы.
- n = 3: F(3) = F(2) + G(1) = 1 + 2 = 3; G(3) = G(2) + F(2) = 2 + 1 = 3. Каждая функция берёт одно значение из своего столбца и одно из соседнего.
- Остальные строки считаются так же по уже заполненным: сначала F(n), потом G(n). Вся таблица ниже.
- Ответ стоит в строке n = 8 столбца F: F(8) = 44.
from functools import lru_cache @lru_cache(None)def F(n): if n <= 2: return 1 return F(n - 1) + G(n - 2) @lru_cache(None)def G(n): if n <= 2: return 2 return G(n - 1) + F(n - 1) # Значения, которые считает программа:# n 1 2 3 4 5 6 7 8# F(n) 1 1 3 5 8 14 25 44# G(n) 2 2 3 6 11 19 33 58print(F(8)) # 44 — совпало с таблицейprint(F(10)) # 135F вызывает G, то функцию G обязательно нужно определить раньше F.G ищется в момент вызова, а не в момент записи def F. Достаточно, чтобы к первому вызову обе функции уже существовали: сначала обе def (каждая со своим декоратором), потом print. Ошибка NameError появляется, если вызвать F(...) выше определения G.Сколько n удовлетворяют условию
В части заданий спрашивают не значение, а количество аргументов: «сколько существует n от 1 до 500, для которых F(n) = 16». Здесь функция вызывается для каждого n по очереди, поэтому без кеша работа умножилась бы на число проверок, а с общим кешем каждое значение считается один раз. Общий шаблон: цикл по аргументам, условие на значение и счётчик. Перед тем как считать сотни значений, полезно вывести первые несколько и сверить их с ручным счётом — так проверяется сама функция.
- Первые значения F(1), …, F(12): 1, 4, 5, 7, 8, 8, 9, 10, 11, 11, 12, 11. Их можно проверить вручную, так же как мы проверили F(21) = 15.
- Перебираем n от 1 до 500 включительно и считаем случаи, где
F(n) == 16. - Подходят 23, 27, 29, 30, 32 — всего 5. Для контроля проверим n = 30 вручную: F(3) = 5, F(6) = 8, F(7) = 9, F(14) = 12, F(15) = 13, F(30) = 16.
count = 0for n in range(1, 501): # 501: 500 должно войти в перебор if F(n) == 16: count += 1 print(count) # 5print([n for n in range(1, 501) if F(n) == 16])# [23, 27, 29, 30, 32]Большие n: сокращаем, а не считаем
До этого нам было нужно само значение функции, поэтому мы шли от базы до нужного аргумента. Но если аргумент огромный — 2024, 100 000 — а нужен не сам F(n), а отношение или разность двух соседних значений, считать всю последовательность необязательно. Обычно достаточно раскрыть только несколько последних шагов и что-то сократить. Методические рекомендации ФИПИ к заданию 16 советуют именно это: сначала проанализировать выражение на предмет упрощения, а не сразу писать программу — для N!/(N − 1)! факториалы вычислять не нужно. Если в выражении несколько значений функции, например (F(100) + 3·F(99)) / F(98), все они выражаются через самое «маленькое» из них, F(98), после чего общий множитель выносится и сокращается: (100·99·F(98) + 3·99·F(98)) / F(98) = 9900 + 297 = 10197.
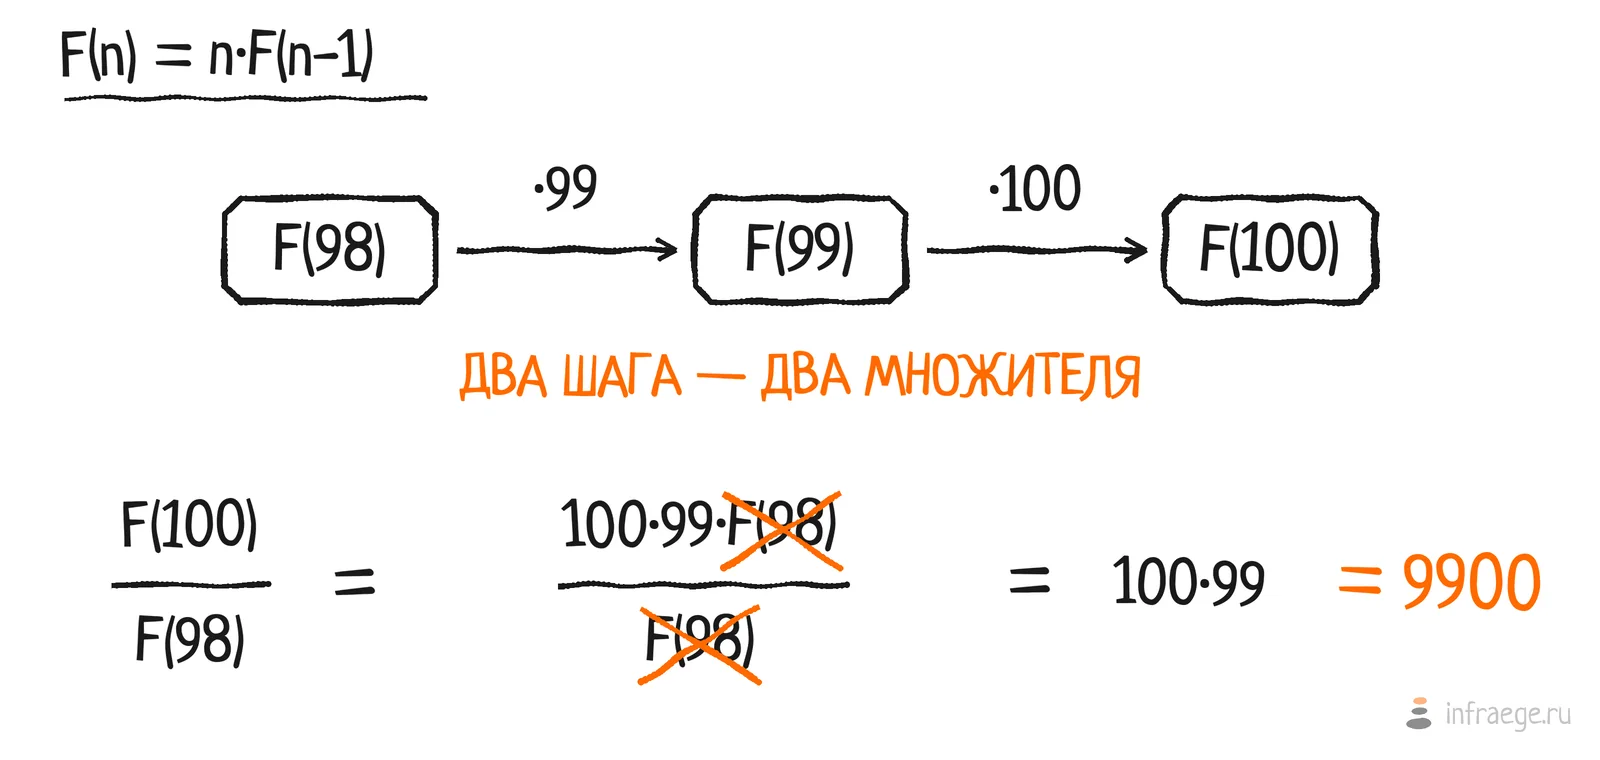
- F(99) = 99·F(98).
- F(100) = 100·F(99) = 100·99·F(98).
- F(100) / F(98) = 100·99·F(98) / F(98) = 100·99 = 9900.
Разность значений и когда сокращение не работает
Если формула складывает, а не умножает, сокращается разность, а не отношение. Для F(n) = F(n − 1) + 2n + 3 каждое значение отличается от предыдущего на 2n + 3, поэтому F(n) − F(n − k) — сумма k таких добавок. Когда слагаемых много, их складывают как арифметическую прогрессию: количество слагаемых умножить на полусумму первого и последнего.
Не всякая формула сокращается «нацело». Пусть F(1) = 1, F(n) = n·F(n − 1) − 1. Раскроем три шага: F(200) = 200·F(199) − 1, затем F(199) = 199·F(198) − 1, затем F(198) = 198·F(197) − 1. После подстановки F(200) = 200·199·198·F(197) − 200·199 − 200 − 1 = 7 880 400·F(197) − 40 001. Значит, F(200) / F(197) = 7 880 400 − 40 001 / F(197). Значение F(197) огромно, поэтому вычитаемая дробь больше нуля, но меньше единицы, и число чуть меньше 7 880 400: его целая часть равна 7 880 399. Если задание просит «целую часть», оценка такого вида — законный способ, а если формула сокращается точно, как в предыдущем разделе, целая часть не нужна.
- F(1000) = F(999) + 2·1000 + 3 = F(999) + 2003.
- F(999) = F(998) + 2001 и F(998) = F(997) + 1999.
- F(1000) − F(997) = 2003 + 2001 + 1999 = 6003. Базовое значение F(1) в ответ не вошло.
- Проверка вторым способом: программа с циклом (значение зависит от предыдущего) даёт то же число.
f = {1: 5}for n in range(2, 1001): # 1001: включаем n = 1000 f[n] = f[n - 1] + 2 * n + 3 print(f[1000] - f[997]) # 6003Шаблон программы для задания 16
Соберём выученное в шаблон программы. Каждая строка отвечает на конкретную проблему, которую мы уже видели:
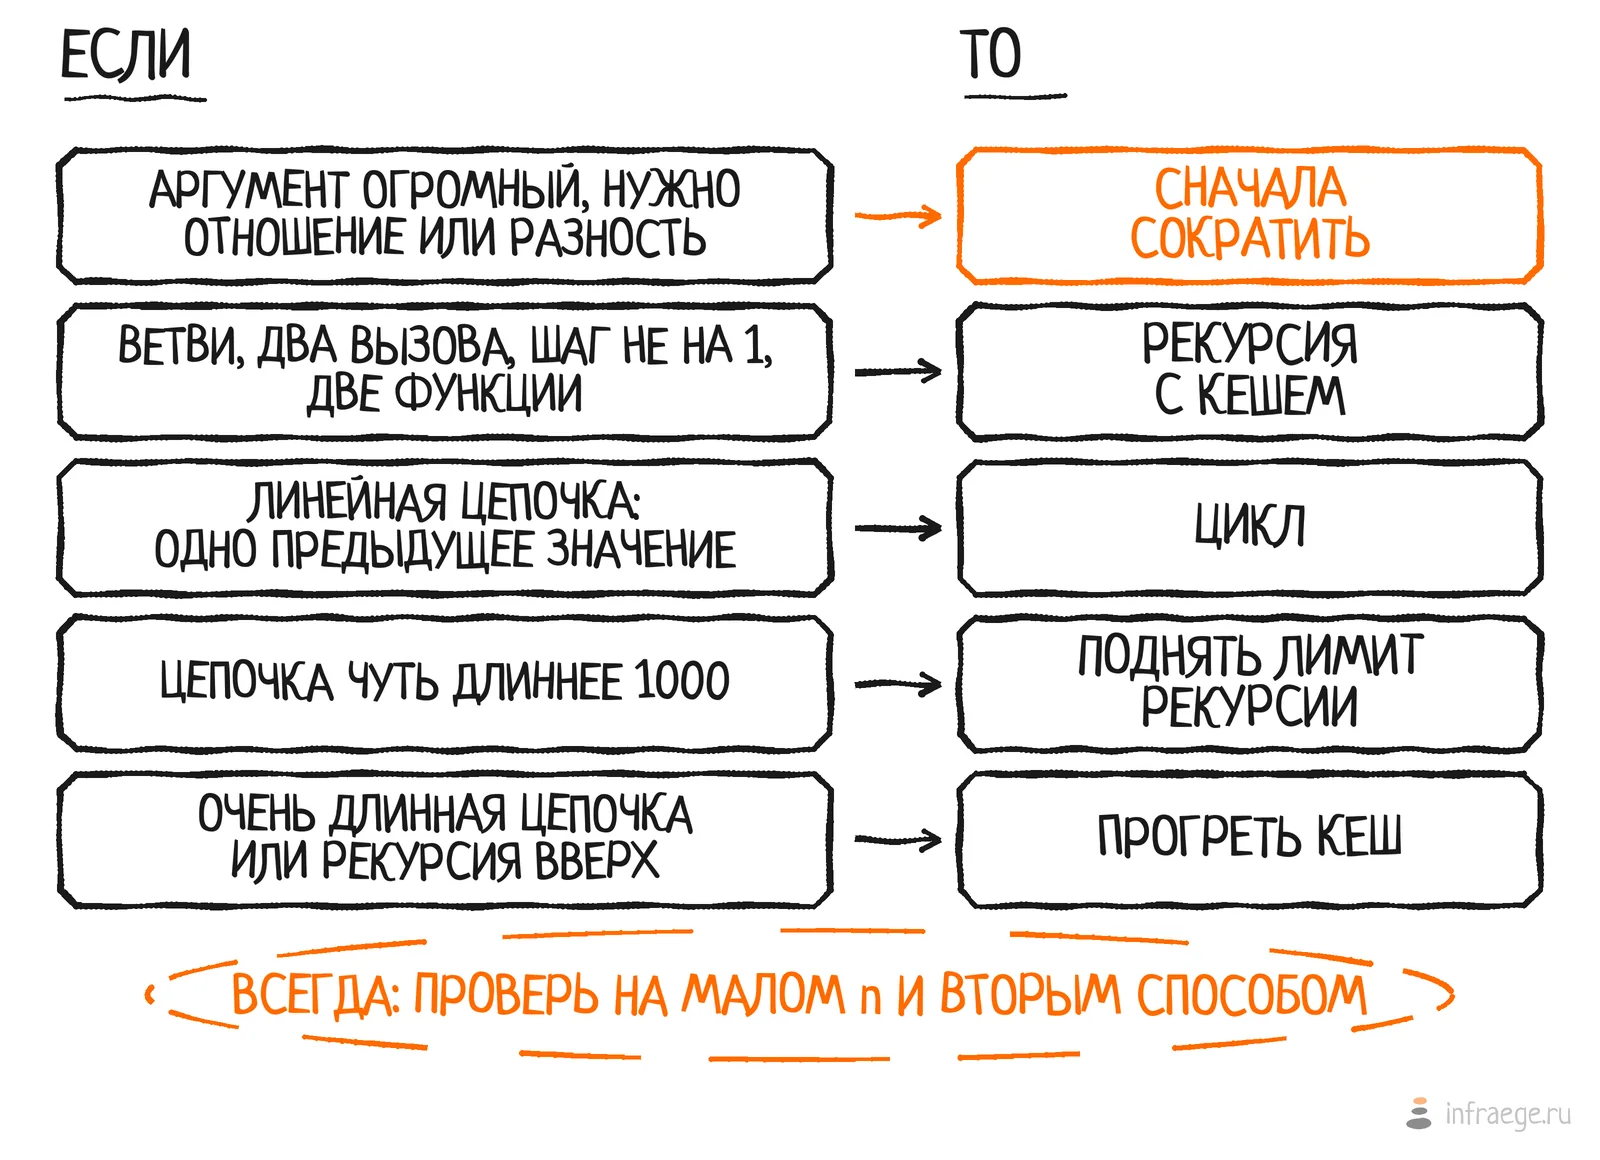
import sysfrom functools import lru_cache # Если цепочка вызовов длиннее 1000sys.setrecursionlimit(10000) @lru_cache(None) # Значение считается один разdef F(n): if n <= 3: # База проверяется первой return ... if n % 2 == 0: # Ветви в порядке условия return ... return ... # Прогрев кеша, если цепочка слишком длинная:# for n in range(...): F(n)print(F(...))Из шаблона не нужно брать всё сразу. Импорт sys и setrecursionlimit нужны только при длинной цепочке; прогрев кеша — при рекурсии вверх или очень длинной цепочке; кеш — почти всегда, когда есть два и более рекурсивных вызова. И перед тем как отдавать ответ, программу проверяют на малом значении, которое можно посчитать вручную.
- База: n ≤ 3 — значение 2. Ветви: чётное n и нечётное n.
- Ручная проверка: F(4) = F(3) + F(1) = 4, F(5) = F(3) + 5 = 7, F(6) = F(5) + F(3) = 9, F(7) = F(5) + 7 = 14, F(8) = F(7) + F(5) = 21, F(9) = F(7) + 9 = 23, F(10) = F(9) + F(7) = 37.
- Программа для F(10) должна вывести 37; глубина цепочки для F(60) мала, поэтому лимит и прогрев не нужны — достаточно кеша.
from functools import lru_cache @lru_cache(None)def F(n): if n <= 3: return 2 if n % 2 == 0: return F(n - 1) + F(n - 3) return F(n - 2) + n print(F(10)) # 37 — как при ручной проверкеprint(F(60)) # 1737Общий алгоритм решения
Мы рассмотрели несколько разных формул и способов вычисления. Теперь соберём их в один алгоритм для задания 16:
- Определите область n и базовые значения. Аргумент натуральный, n ≥ 0 или задан отдельно; базовые значения даны в условии — их не нужно вычислять. Проверьте, что база находится там, куда ведёт цепочка (внизу или, как F(n + 4), вверху).
- Определите вид зависимости. Одно или несколько предыдущих значений, разные формулы для чётных и нечётных n, шаг не на 1 (
//,%), рекурсия вверх или две связанные функции. - Сначала попробуйте упростить. Огромный аргумент и отношение или разность соседних значений — повод раскрыть несколько шагов и сократить. Не сокращается точно — оцените поправку.
- Выберите инструмент. Маленький аргумент — таблица вручную; рекурсия с @lru_cache(None) — если есть ветви, два и более вызова, шаг не на 1 или две функции; цикл — для линейной цепочки; лимит рекурсии — если цепочка чуть длиннее 1000; прогрев кеша — при очень длинной цепочке или рекурсии вверх.
- Проверьте, что аргумент приближается к базе. F(n) → F(n − 1) → F(n − 2) → … должно дойти до известного значения, а базовые случаи проверяются в программе первыми.
- Проверьте границы и малые значения.
range(a, b)не включает b. Программа для малых n должна совпасть с ручным счётом. - Подтвердите ответ вторым способом. Кеш — циклом или списком; программа — упрощением; рекурсия вверх — разностью. Если два способа расходятся, ошибка есть в одном из них.
Практика
Для проверки ответов нужен JavaScript. Условия, подсказки и решения доступны ниже.
Вычислите последовательность
Подсказка
Начните с F(1) и последовательно найдите F(2), F(3), F(4), F(5).
Решение
Вычислим значения снизу вверх.
- F(2) = 8
- F(3) = 14
- F(4) = 22
- F(5) = 32
Проследите рекурсивные вызовы
Подсказка
Сначала найдите F(3), затем F(4). Каждый вызов должен дойти до одного из двух базовых случаев.
Решение
Раскрываем вызовы снизу вверх, не пропуская оба базовых случая.
- F(1) = 1 и F(2) = 2 — готовые базовые значения.
- F(3) = F(2) + 2F(1) = 2 + 2 · 1 = 4.
- F(4) = F(3) + 2F(2) = 4 + 2 · 2 = 8.
- F(5) = F(4) + 2F(3) = 8 + 2 · 4 = 16.
Та же рекуррентная формула в Python
def f(n): if n == 1: return 1 if n == 2: return 2 return f(n - 1) + 2 * f(n - 2) print(f(5)) # 16Используйте два предыдущих значения
Подсказка
Храните два последних значения и не пропускайте F(3) и F(4).
Решение
Последовательно применим формулу.
- F(3) = 5
- F(4) = 12
- F(5) = 29
Посчитайте повторяющиеся вызовы
Подсказка
Обозначьте число вызовов через C(n). Для базовых случаев C(0) = C(1) = 1, а для остальных C(n) = 1 + C(n - 1) + C(n - 2).
Решение
Считаем не значения F, а количество входов в функцию. Единица в формуле C(n) учитывает текущий вызов, а два слагаемых — обе рекурсивные ветви.
Последовательно найдём размеры деревьев вызовов.
- C(0) = 1 и C(1) = 1.
- C(2) = 1 + 1 + 1 = 3.
- C(3) = 1 + 3 + 1 = 5, C(4) = 1 + 5 + 3 = 9.
- C(5) = 1 + 9 + 5 = 15, C(6) = 1 + 15 + 9 = 25.
Сохранение результатов устраняет повторные вычисления
from functools import cache @cachedef f(n): if n <= 1: return 1 return f(n - 1) + f(n - 2)Сократите отношение
Подсказка
Раскройте только F(100) и F(99), не вычисляя всю последовательность.
Решение
Выразим соседние значения через F(98).
- F(99) = 99F(98)
- F(100) = 100 · 99F(98)
- F(100) / F(98) = 9900
Итог
Что получилось
Рекурсивное определение — это не логический круг, а последовательность: одно или несколько первых значений уже известны, а каждое следующее выражается через уже найденные. Вся задача сводится к тому, чтобы понять, от чего зависит формула и куда ведёт цепочка, и добраться от базы до нужного аргумента, ни разу не потеряв базовый случай.
Как считать — рекурсией с кешем, циклом, списком, прогревом кеша или алгебраическим сокращением — решает не личный вкус, а то, что именно даёт формула: маленький или огромный аргумент, ветвление, шаг не на 1, одна функция или две, число, количество аргументов или разность соседних значений. И в любом случае ответ проверяют: на малых значениях и вторым способом.
Дано F(1) = 5 и F(n) = F(n − 1) + 3 при n > 1. Можно ли подставить n = 1 в рекуррентную формулу, чтобы найти ещё одно значение?
Чему равно F(3) для той же функции?
В программе с печатью для F(4) в каком порядке появятся строки «возврат»: от большего n к меньшему или наоборот?
Функция задана как F(1) = 1, F(2) = 1, F(n) = F(n − 1) + F(n − 2). Что станет главной проблемой прямой рекурсии при F(40): глубина стека или что-то другое?
Чем @lru_cache(None) отличается от @lru_cache() без аргумента?
None снимает ограничение размера, и кеш запоминает все значения. Без аргумента Python помнит только 128 последних, старые вытесняются и могут вычисляться снова — для длинных цепочек и перебора аргументов это плохо.Почему два последних значения нельзя бездумно обновлять двумя последовательными присваиваниями?
Что вернут 9 / 3 и 9 // 3? Почему это важно, когда аргумент функции должен остаться целым?
9 / 3 даёт 3.0 — дробное число, а 9 // 3 даёт 3 — целое. Для огромных аргументов дробное деление теряет цифры, поэтому аргументы делят через //.Почему в функции с ветвями по чётности базовый случай проверяют раньше веток?
Функция задана как F(n) = F(n + 3) + 1 при n < 5000. В каком порядке прогревать кеш?
Нужно посчитать n от 1 до 300 включительно. Какую строку цикла написать?
for n in range(1, 301): — правая граница range не входит, поэтому берётся «последнее нужное значение + 1».Если F(n) = n·F(n − 1), нужно ли вычислять всю последовательность от F(1), чтобы найти F(2024) / F(2022)?
Выберите способ вычисления для каждого условия: (а) F(n) = 3·F(n − 1) + 2, нужно F(50); (б) значение зависит от F(n // 2) и чётности n; (в) нужна разность F(3000) − F(2997) для F(n) = F(n − 1) + n.
@lru_cache(None). (в) Разность из трёх шагов — сумма 3000 + 2999 + 2998 без программы; программой подтверждают ответ.